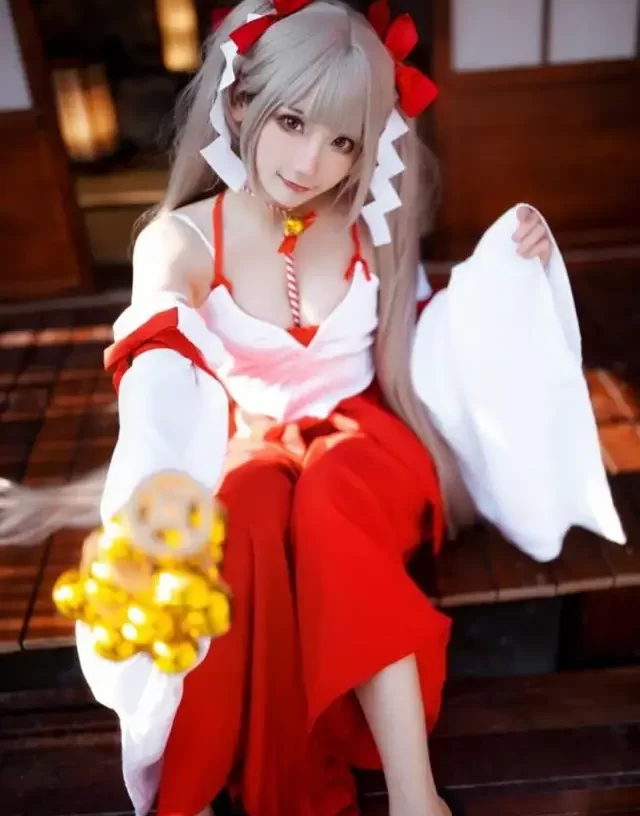

铃饰停在木廊前。是三不是世w的浅金双马尾系着红色蝴蝶结,头部还带有白色纸饰,白红衣装与木廊形成了几种不同的边缘:头发柔软,纸饰有折角,手中的铃则带着小而密的轮廓。
从红色发结看到手里的铃
这张坐姿照片有两处适合停留的细节。头部的红色发结把浅金头发分成左右两侧,手中的铃饰则把注意力带到身体前方。你可以沿着这条观看路线读图,先认清头饰,再看手握住道具的位置,不必急着给人物指定一个角色名字。
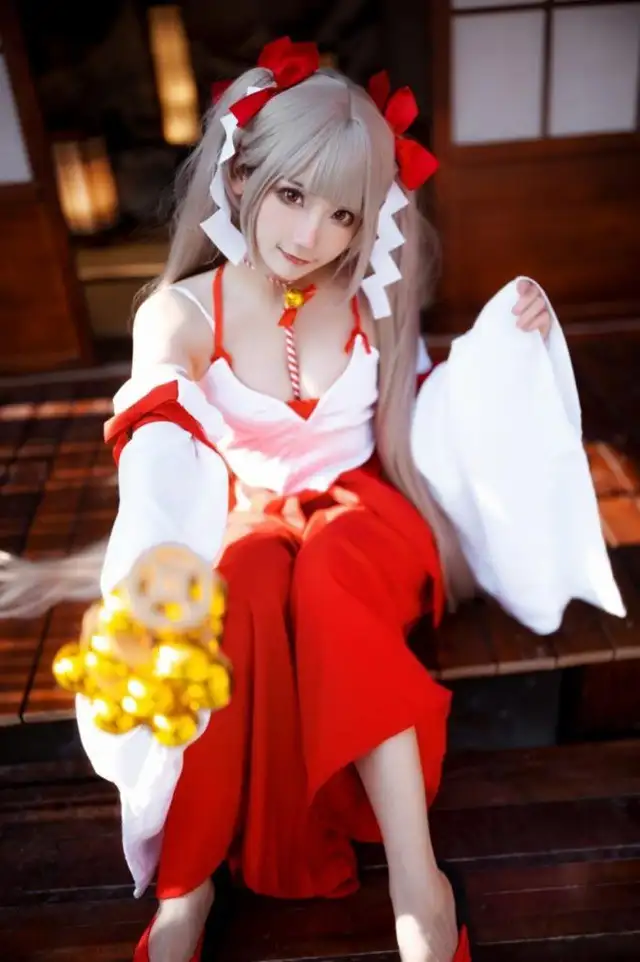
白色衣料和纸饰都比较浅,形状却不同。衣料随坐姿折叠,边缘有垂落感;纸饰的转折更明确,读起来接近折线。它们放在同一幅图里,区别来自形状、厚度与明暗,不是简单地把白色调得更亮。
木廊也参与了这张照片的组织。坐姿让人物与地面有了接触,衣摆不再只沿身体向下,而会受到坐姿和地面的影响。你看衣服时,应该把支撑面一起看进去,否则容易把自然堆叠的布料误读为衣装本身的结构。
同样有头饰和浅色衣服,千阳(ちよ)的近景更靠材料边缘区分层次。把两篇放在一起时,可以只比较头部附近的细节,先不考虑拍摄题材:一边是发结和纸饰,一边是耳饰、辫子或毛绒,它们需要的辨认距离并不相同。
铃饰看着清楚,能说明多少画质信息
缩略图里能认出铃,不代表放大后每一处轮廓都有细节。小尺寸展示会把细小纹理压在一起,让画面显得干净;这时你能够判断的是构图是否清楚,尚不能判断道具表面的纹路是否完整。
往下一层看,需要把图片放到适合检查细节的尺寸。你可以观察铃饰边缘是否有断裂、发丝之间是否还有间隙、纸饰折角是否呈现自然的过渡。它们分别涉及细线、密集纹理和明暗边界,比只盯着脸部是否平滑更有参考价值。
再往下,才是区分问题来源。细节模糊可能来自失焦、动作、压缩,也可能是后期处理;单看文件很大,很难知道究竟是哪一项。照片如果经过放大保存,像素数量增加了,原来没有记录下来的纹理却不会因此自动出现。
张数也回答不了这些问题。
一组照片增加了几个不同角度,可以帮助你看清铃的握持关系;如果只是同一动作的连续近似画面,新增张数带来的信息就有限。评价指标时,要先问它测量的是什么,再决定用它回答哪一个问题,别让容量、张数和细节混成同一件事。
红衣和浅金发,调色时各看两种尺寸
调色前可以准备两种观看方式:完整画幅看色彩分布,百分之百显示看边缘和纹理。这两种尺度解决的问题不同。整体图里红色是否抢眼,不等于放大后红色衣料的褶皱是否还分得开。
以白红衣装为例,红色加深以后,整张图可能更醒目,但暗红区域之间的差别也可能变小。你需要回到衣料转折处,检查阴影和布面是否仍然各有层次。若所有暗处都挤成同一种红,单纯再加锐度通常不能补回已经丢掉的色阶。
浅金头发则要单独观察。全局色温变化会同时影响头发、肤色、木廊和白衣,某一处变得讨喜,其他位置未必也合适。试调时可以先做一个小幅版本,与原来的显示并排比较,确定变化确实解决了问题,再决定是否继续。
你还可以看妖少you1的蓝花场景。同样是鲜明色彩,花朵、衣料与木质背景的分布不同,不能把一张图的调整幅度直接搬过去。比较的重点是颜色有没有压住材料本身,而不是哪一张饱和度更高。
持铃短片,动作要拍到哪里才算完整
如果把持铃坐姿拍成一段短片,应该从举起道具拍到哪里?一个实用的答案是:保留动作起点、移动过程和停稳后的片刻,让观者能够看懂手与道具之间的关系,而不是只截取铃离脸最近的那一帧。
开始时,先让手和铃的位置清楚。动作进行中,注意袖口有没有挡住握持处,头发有没有落到道具前面;停下来之后,再给观者一点时间辨认姿势。这里说的是造型展示的拍摄思路,不据照片推断现场是否进行过特定仪式,也不把摆拍动作当作规范示范。
运动与静止会暴露不同的问题。静态图里,铃饰只要在一个瞬间清楚即可;连续画面里,相邻时刻的遮挡、晃动和重心变化都能被看到。镜头不必一直移动,固定机位也可以把这些变化记录下来,移动过多反而会让道具的小动作更难辨认。
素材清单中有两套标注带视频,但这不足以证明本页造型存在对应短片。观看视频时,判断动作是否交代完整,比仅凭“附带视频”几个字想象拍摄内容更可靠。回到前面的提问,动作结束的标准应是关系看清、姿态停稳,而不只是铃被举起来了。
给木廊持铃照片留下可找回的标签
“浅金双马尾、木廊、持铃”就是一组可以直接用于查找的描述。它们分别对应发型、场景和道具,即使暂时不知道角色名,也能帮助你在相近图片中重新找到这张照片。
整理时可以保留原文件名,把自己的描述写在索引里。原始名称负责追溯来源,自拟标签负责回答你记得的画面特征;两者分开,日后补上更准确的角色信息时,就不用推翻整套命名。尤其不要因为衣装相似,就给一批照片全部套上同一个角色标签。
颜色可以做入口,但最好再加一个动作或场景。“白红衣服”可能对应很多照片,“白红衣服、坐姿、木廊”就具体得多。标签也不必越细越好,给每一片衣褶都起名字,只会让维护索引比重新看图还费时。
上杉绘梨落的手机夜景可以用“天桥、手机、夜景”查找,方法与这里相同。把你真正会记住的视觉线索留下来,等到需要比较道具姿势或衣料表现时,就能沿着这些线索找到图片。
